기업용 AI 에이전트의 발목을 잡는 것은 모델이 아닌 데이터 준비도
기업의 57%가 AI 에이전트를 도입했지만, 데이터가 프로덕션에 준비된 곳은 8%에 불과하다. 그 격차를 분석한다.
핵심 요약
- 도입 속도가 신뢰를 앞질렀습니다. 조사 대상 조직의 절반 이상이 데이터·분석 업무에서 에이전트를 시범 운영하거나 운영하고 있지만, AI 데이터가 실제 운영에 쓸 준비가 되었다고 답한 곳은 10곳 중 1곳도 되지 않습니다.
- 가장 큰 걸림돌은 데이터입니다. 데이터 리더와 실무자의 75.9%가 데이터 품질과 신뢰를 3대 장애 요인으로 꼽았으며, 기술 인력 부족을 꼽은 비율은 25.9%였습니다.
- 더 좋은 모델로는 격차가 줄지 않습니다. 실제 기업 데이터베이스에서 가장 성능이 좋은 에이전트조차 과제의 21.3%만 해결했습니다. 반면 GPT-4 기반 방법은 더 단순한 Spider 1.0 벤치마크에서 91.2%를 기록했습니다.
- 데이터 거버넌스가 신뢰를 만듭니다. 데이터 거버넌스 프로그램을 갖춘 조직의 71%가 자사 데이터를 높이 신뢰한다고 답한 반면, 프로그램이 없는 조직은 50%에 그쳤습니다.
- 하나의 활용 사례부터 시작해야 합니다. 한 업무의 데이터를 정비하면 다음 에이전트에도 재사용할 수 있는 기준이 생깁니다.
AI 에이전트는 고객 문의에 답하거나 기록을 수정하는 등 스스로 정보를 찾아 작업을 수행합니다. 기업의 AI 에이전트 도입은 빠르게 늘고 있지만, 에이전트가 의존하는 데이터는 아직 준비되지 않은 경우가 많습니다.
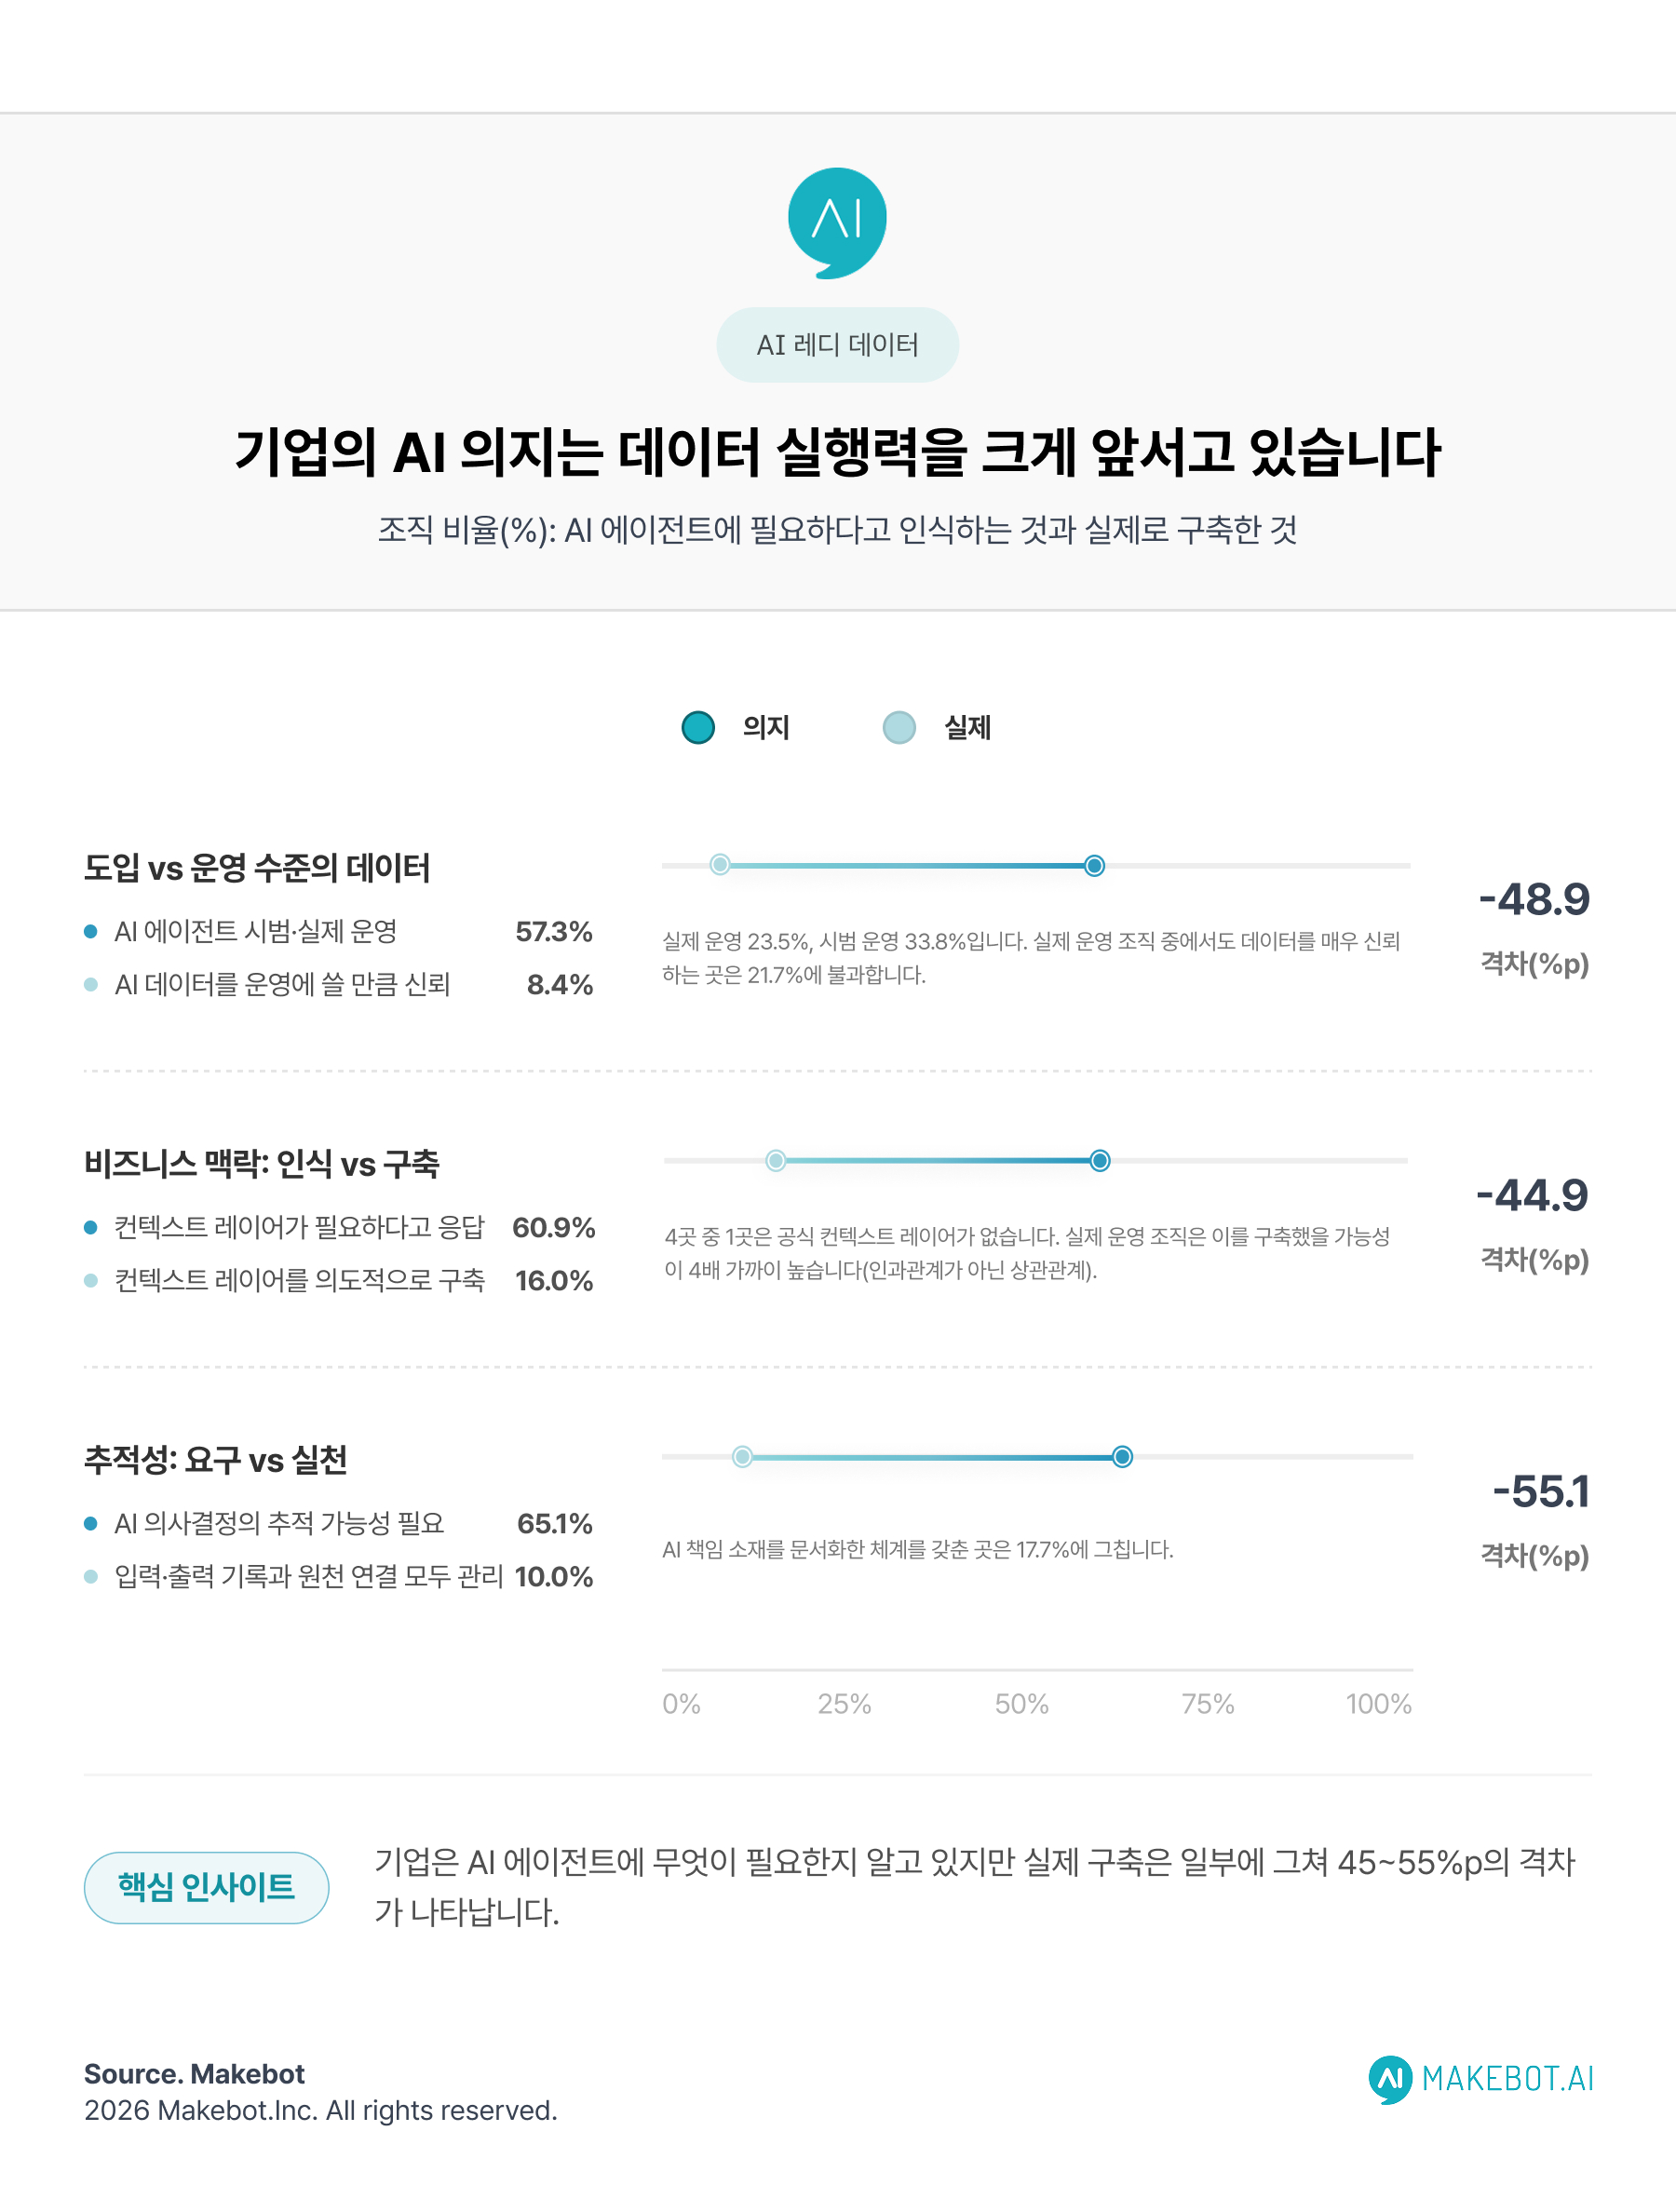
The Modern Data Company의 제3회 Modern Data Survey에 따르면, 응답 조직의 57.3%가 데이터·분석 업무에서 AI 에이전트를 시범 운영하거나 실제로 운영하고 있지만, AI에 투입되는 데이터가 실제 운영 환경에 쓸 만큼 신뢰할 수 있다고 답한 곳은 8.4%에 그쳤습니다. 데모에서 인상적이던 에이전트가 실제 업무에서 멈추는 이유가 바로 이 격차입니다.
많은 기업은 더 똑똑한 LLM (대규모 언어 모델)이 해법이라고 생각합니다. 그러나 근거는 다른 곳을 가리킵니다. 실패의 주된 원인은 데이터 사일로, 메타데이터 누락, 오래된 기록, 불분명한 접근 권한입니다. 기업용 AI 에이전트의 실질적인 병목은 모델이 아니라 AI 데이터의 준비 상태입니다.
AI 레디 데이터(AI-ready data)란 무엇입니까?
AI 레디 데이터란 정확하고 연결되어 있으며 거버넌스와 비즈니스 맥락을 갖춰 AI 에이전트가 신뢰할 수 있는 데이터입니다.
대시보드를 보는 사람은 재무팀 보고서의 '3분기 매출'이 환불을 제외한 수치이고, 영업팀은 계약 체결 건을 기준으로 집계한다는 사실을 압니다. 그러나 에이전트는 누군가 이를 문서화해 데이터와 연결해 두지 않으면 알 수 없습니다. 사람은 모호한 부분을 자연스럽게 보정하지만, 에이전트는 그것을 사실로 받아들입니다.
기업이 가장 크게 뒤처진 부분은 비즈니스 맥락입니다. Modern Data Survey에서 응답자의 60.9%가 AI 에이전트에는 신뢰할 수 있는 컨텍스트 레이어가 필요하다고 답했지만, 이를 의도적으로 구축하는 곳은 16.0%에 불과했습니다. 4곳 중 1곳은 컨텍스트 레이어가 전혀 없었습니다. 에이전트를 실제 운영 중인 조직은 아직 사용하지 않는 조직보다 컨텍스트 레이어를 구축했을 가능성이 4배 가까이 높았습니다. 다만 조사 측은 이것이 인과관계가 아닌 상관관계라고 밝혔습니다.
과도한 자신감도 문제를 가립니다. Drexel University LeBow College of Business와 Precisely가 데이터 리더 505명을 조사한 2026 State of Data Integrity and AI Readiness에서 88%는 자사 데이터가 AI에 준비되어 있다고 답했지만, 43%는 AI를 비즈니스 목표와 연계하는 데 가장 큰 장애물로 데이터 준비도를 꼽았습니다.
기업용 AI 에이전트는 왜 파일럿 이후 확산이 멈춥니까?
기업용 AI 에이전트가 파일럿 이후 멈추는 이유는 실제 운영 데이터가 사일로화되고 오래되었으며 라벨이 없기 때문입니다.
파일럿은 엄선한 데이터, 하나의 연결 시스템, 모든 답변을 확인하는 엔지니어로 이런 문제를 가립니다. 많은 AI 파일럿이 POC 단계에서 멈추는 이유도 여기에 있습니다. 파일럿에서 전사 운영으로 확장하는 순간 이러한 보호 장치는 한꺼번에 사라집니다. 여러 시스템의 실시간 데이터, 부서마다 다른 정의, 역할 기반 권한, 하루 수천 건의 무감독 작업이 그 자리를 채웁니다.
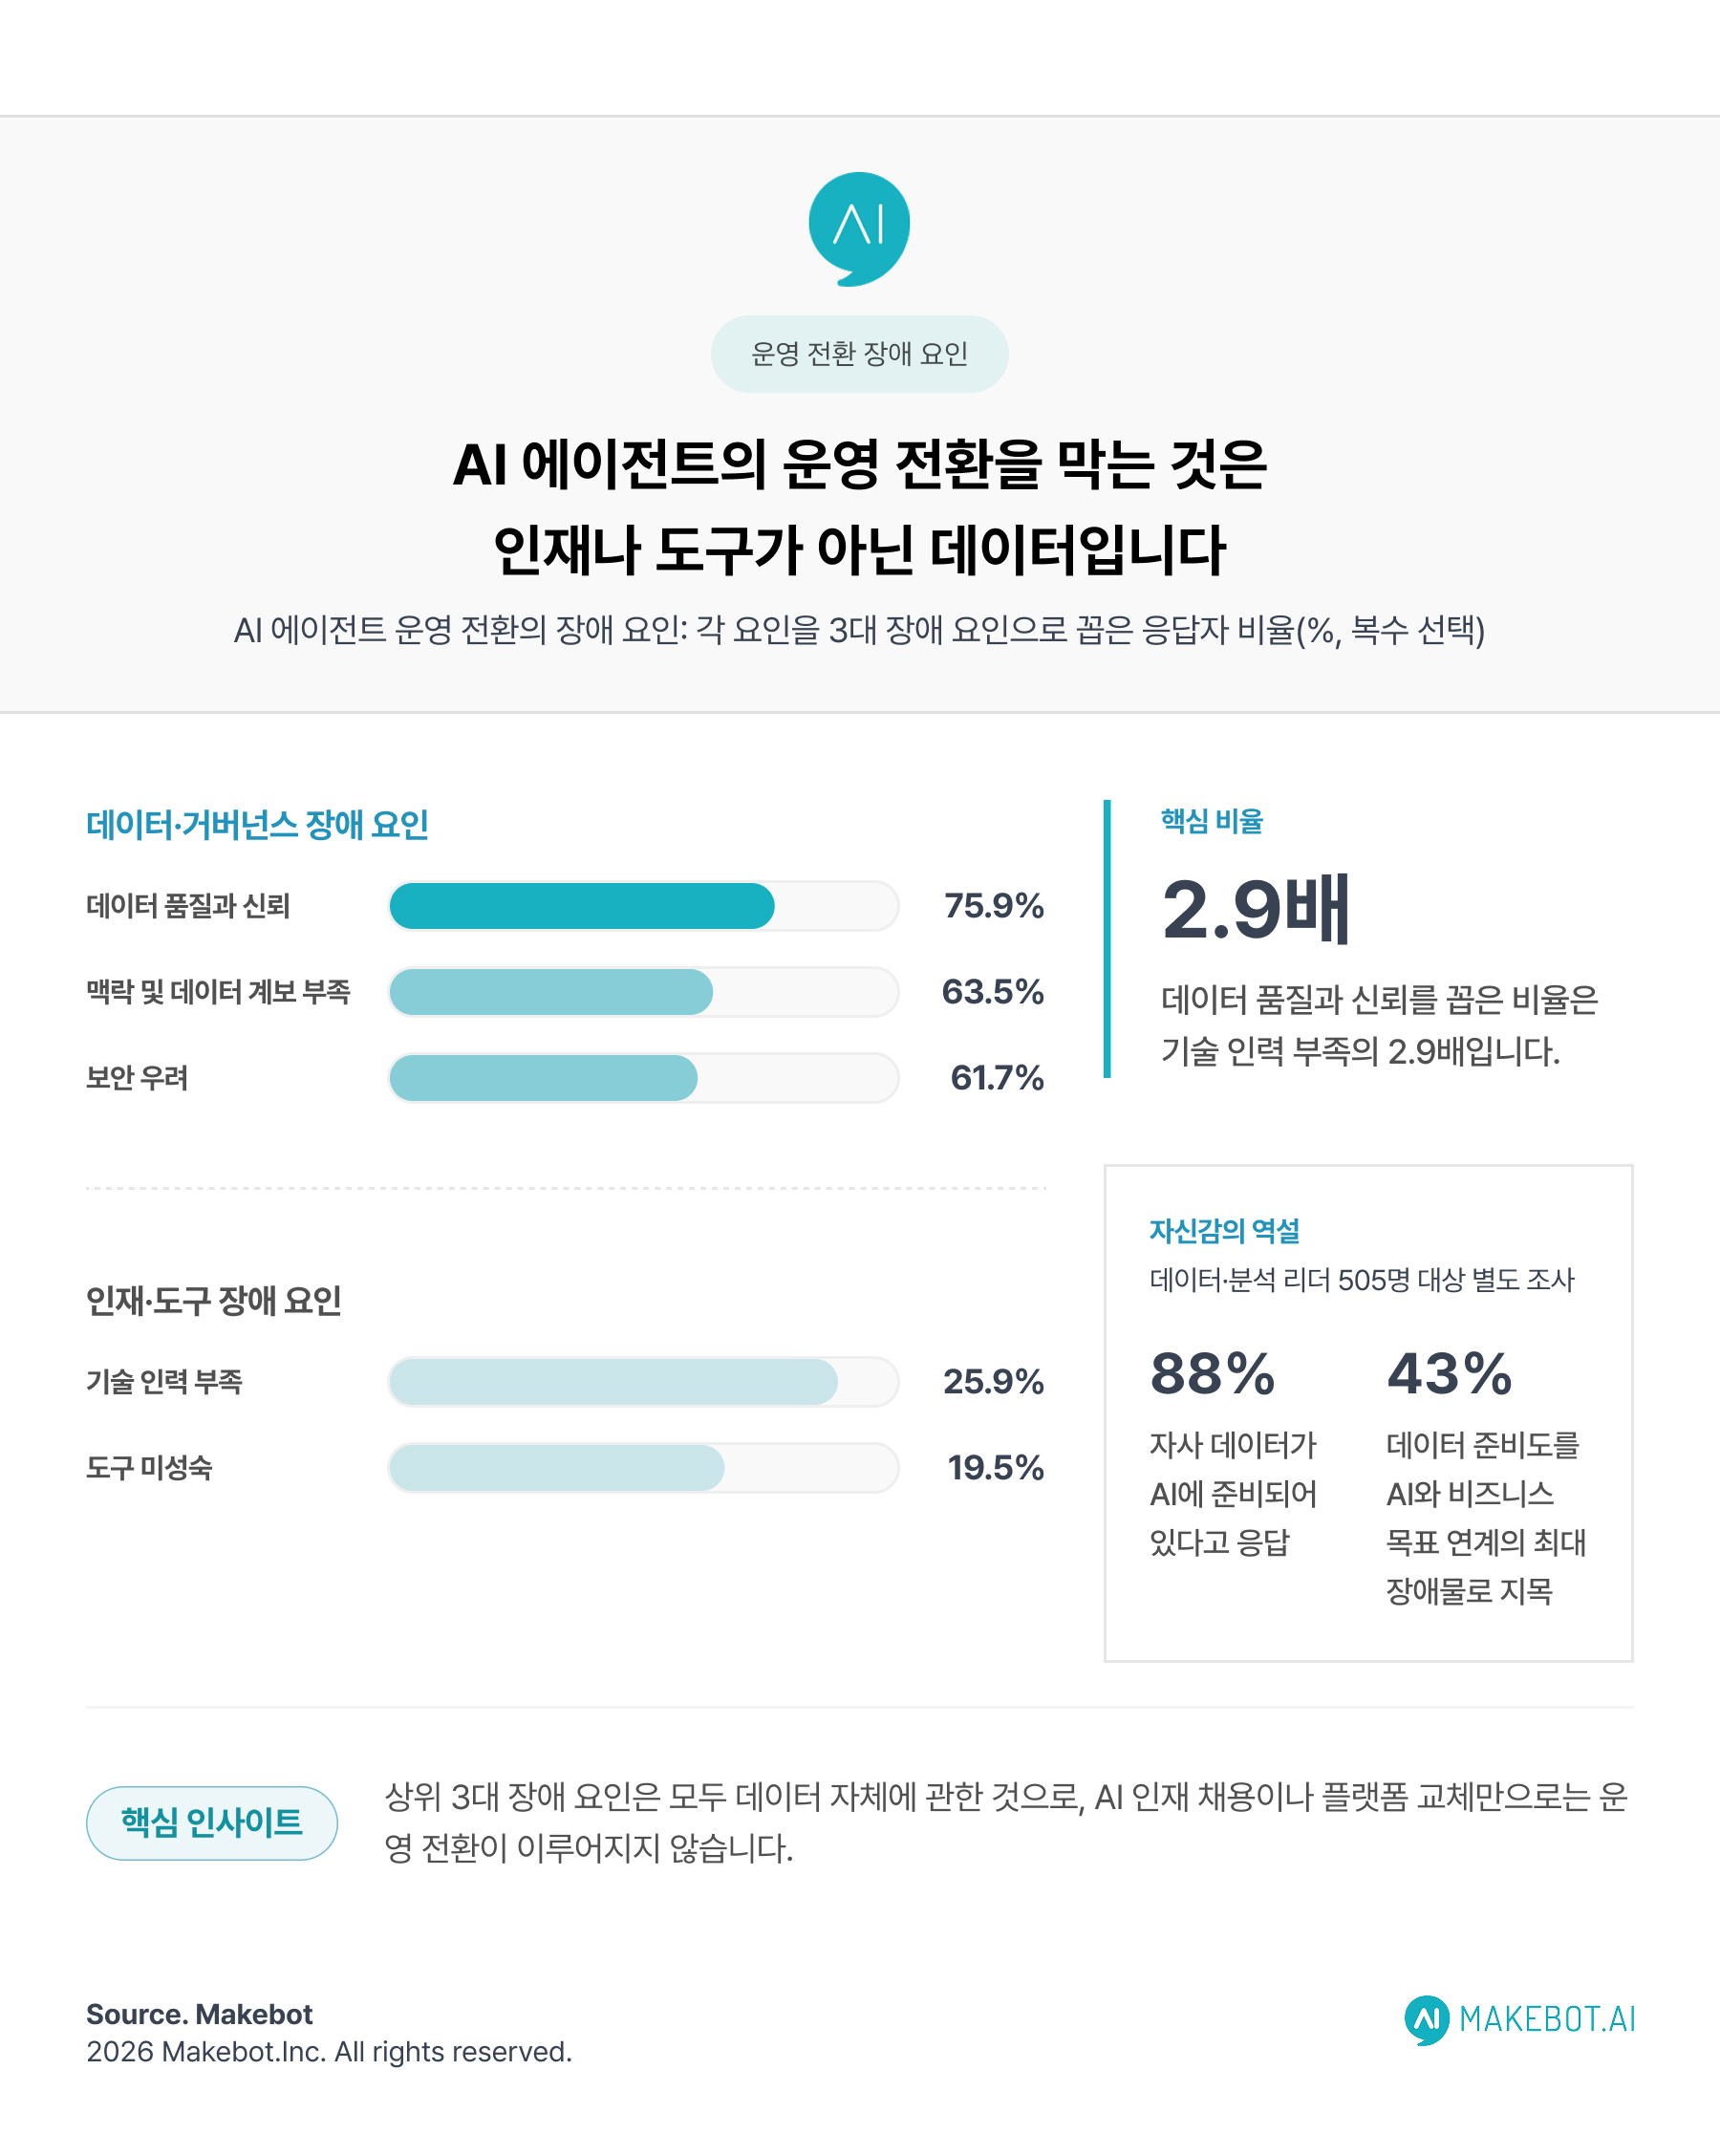
66개국 540명 이상의 데이터 리더가 참여한 Modern Data Survey에 따르면 에이전트를 실제 운영 중인 조직은 23.5%, 시범 운영 중인 조직은 33.8%였습니다. 운영 전환을 가로막는 요인을 묻자 응답자들은 데이터 자체를 지목했습니다. 75.9%가 데이터 품질과 신뢰를, 63.5%가 맥락 및 데이터 계보(lineage) 부족을, 61.7%가 보안 우려를 3대 장애 요인으로 꼽았습니다. 기술 인력 부족과 도구 미성숙은 각각 25.9%, 19.5%에 그쳤습니다.
이미 운영 중인 조직에서도 자사 데이터의 신뢰성을 매우 확신한다고 답한 곳은 21.7%에 불과했습니다. (이 조사는 데이터 플랫폼 기업이 주관하며 아직 진행 중입니다.) 이 중 어느 것도 모델의 문제가 아니므로, 최신 LLM으로 교체해도 멈춘 에이전트는 다시 움직이지 않습니다.
더 뛰어난 LLM으로 데이터 준비 부족을 해결할 수 있습니까?
아닙니다. 더 뛰어난 LLM도 같은 데이터 공백 위에서 추론하므로 데이터 준비 부족을 해결할 수 없습니다.
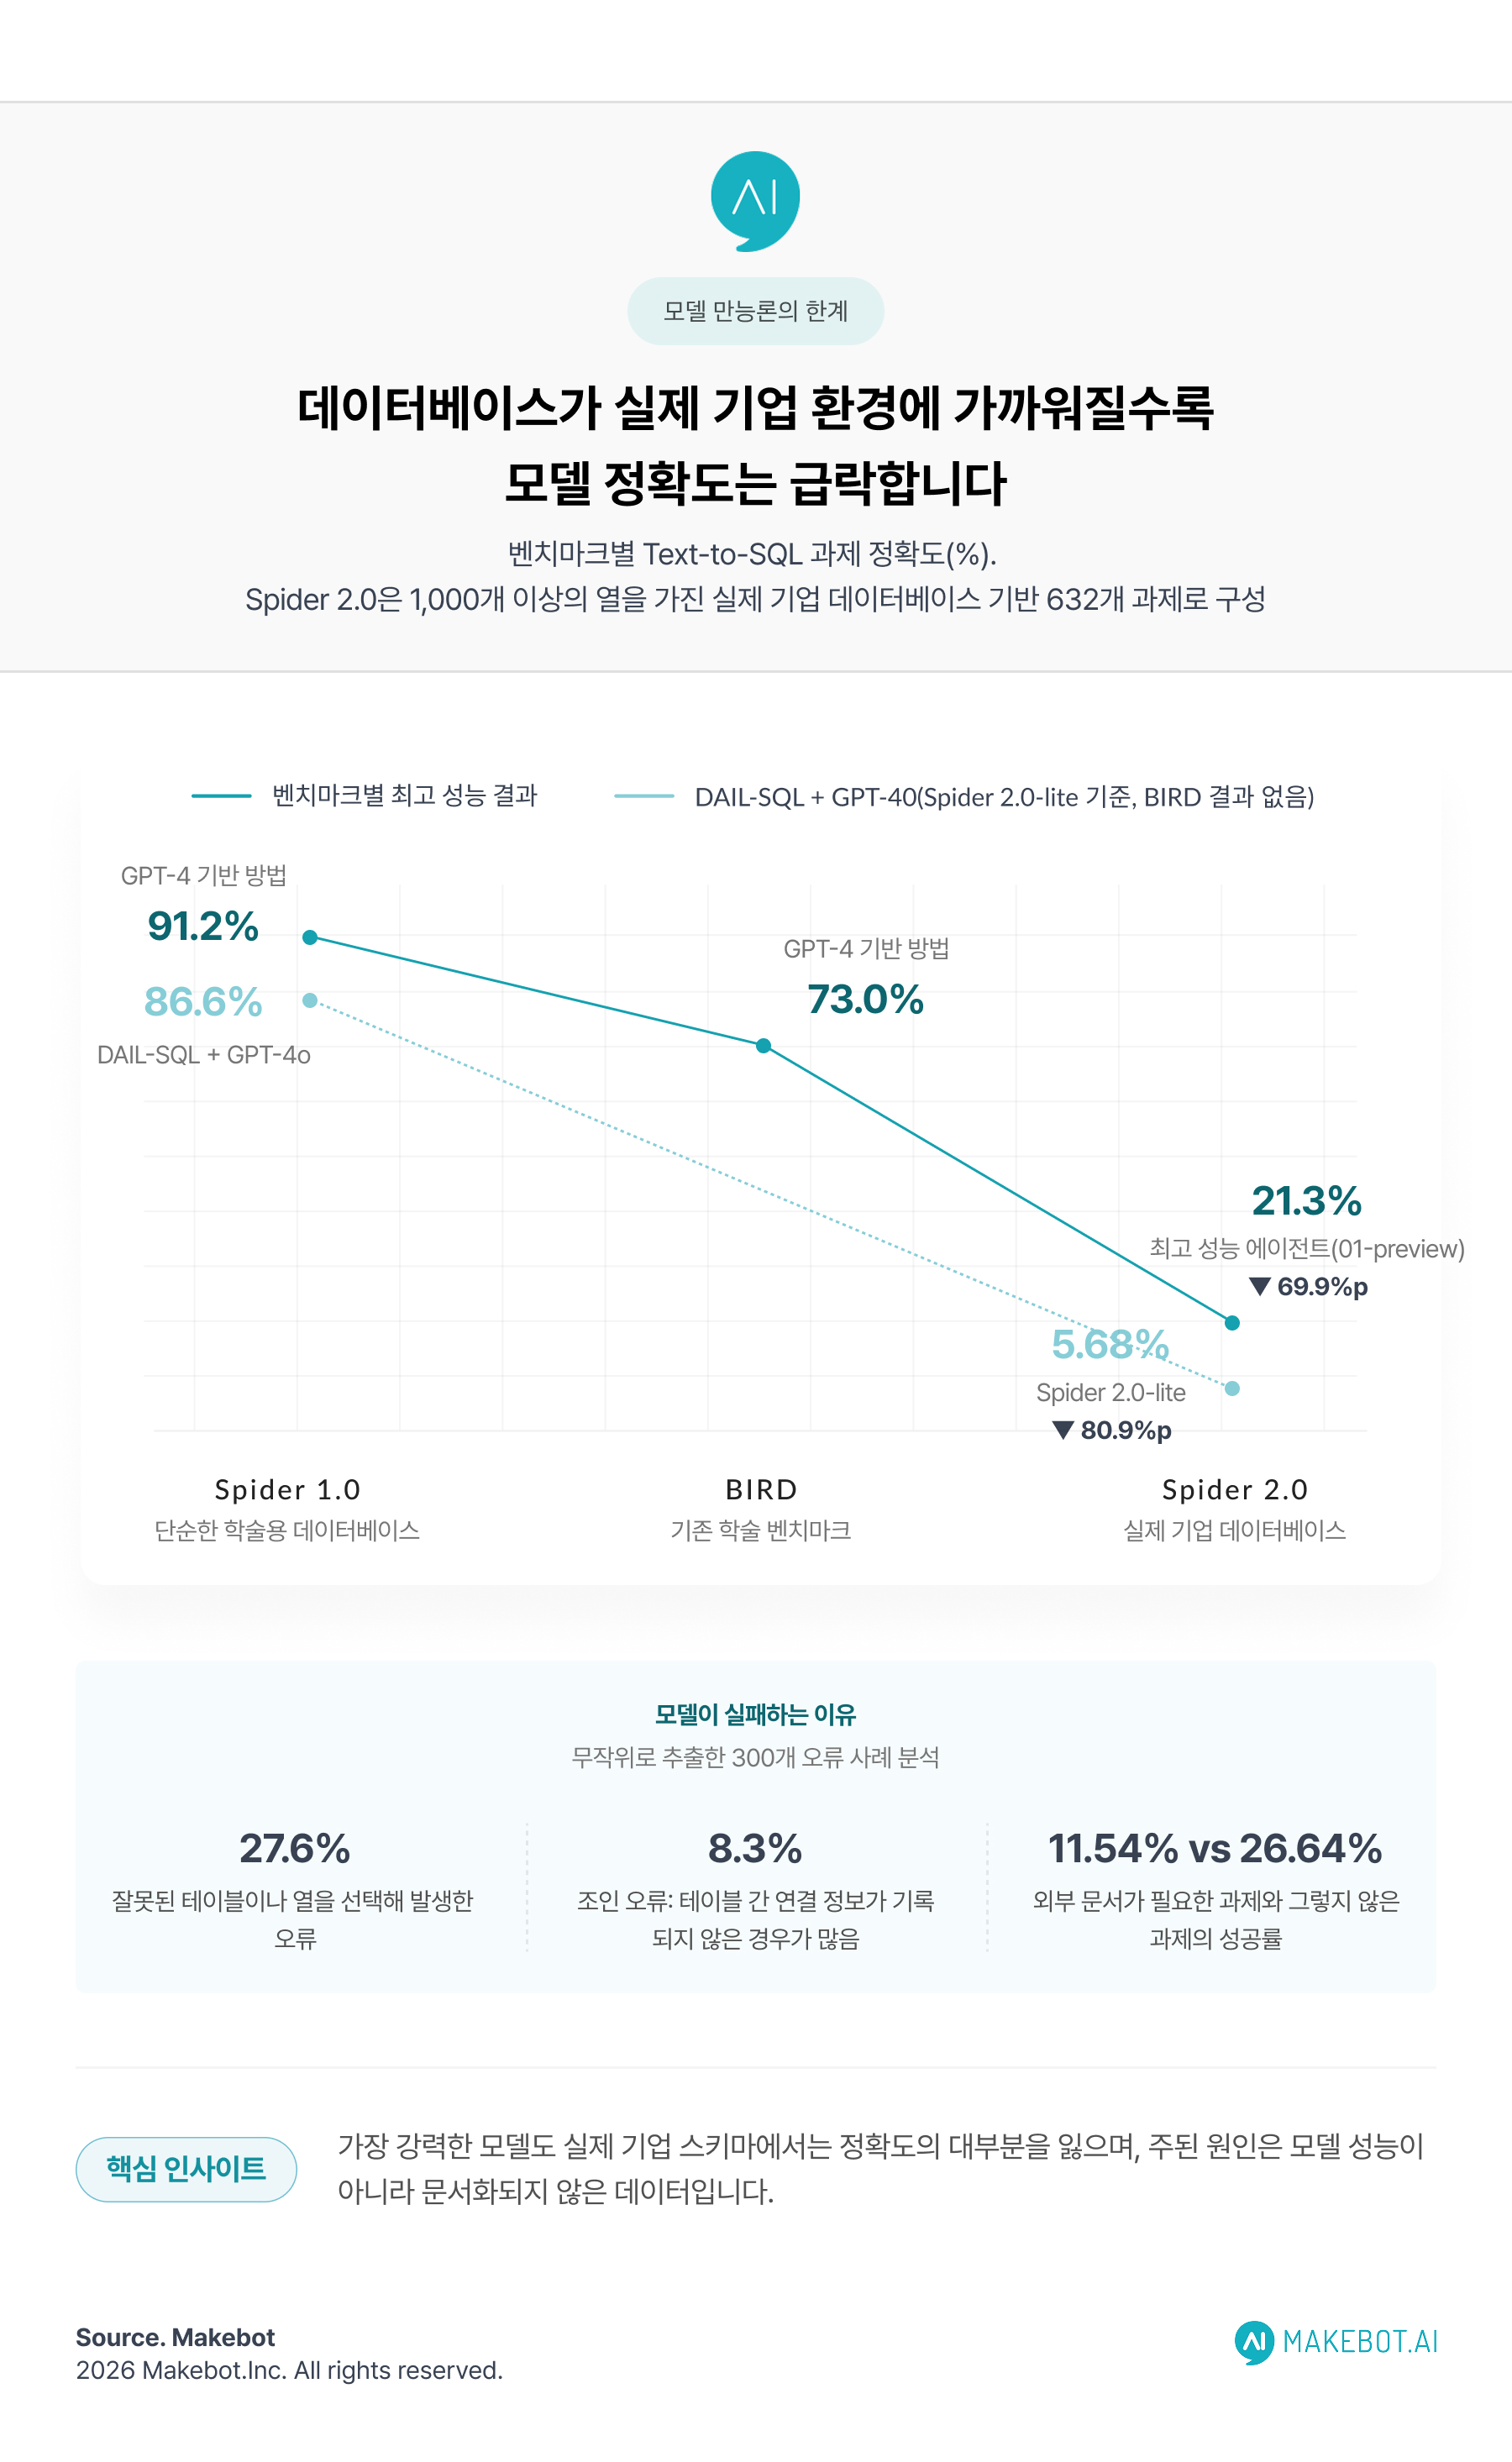
데이터가 부실하면 모델은 확신에 찬 오답을 내놓습니다. 가장 명확한 근거는 University of Hong Kong이 주도한 연구팀이 ICLR 2025에서 발표한 Spider 2.0입니다. 632개 과제는 1,000개가 넘는 열을 가진 경우가 많은 실제 기업 데이터베이스를 바탕으로 합니다. o1-preview 기반의 최고 성능 에이전트조차 과제의 21.3%만 해결했습니다. GPT-4 기반 방법은 더 단순한 Spider 1.0에서 91.2%를 기록했고, DAIL-SQL(GPT-4o 기반)의 정확도는 Spider 1.0의 86.6%에서 Spider 2.0-lite의 5.68%로 떨어졌습니다.
연구진이 무작위로 추출한 300개 오류 사례를 분석한 결과가 그 이유를 보여줍니다.
- 잘못된 테이블이나 열 선택이 오류의 27.6%를 차지했습니다.
- 조인 오류가 8.3%였으며, 테이블 간 연결 정보가 기록되지 않은 경우가 많았습니다.
- 외부 문서가 필요한 과제의 성공률은 11.54%로, 그렇지 않은 과제(26.64%)보다 크게 낮았습니다.
모두 데이터 준비도의 문제입니다. 기업이 한 번도 기록하지 않은 테이블 관계나 지표 정의를 새 모델이 만들어낼 수는 없습니다. 데이터를 먼저 정비한 뒤 자사 데이터로 모델을 테스트해야 합니다. 비즈니스 용어 사전과 문서화된 테이블 관계가 근본 원인을 해결하며, 더 큰 모델을 운영하는 데 따르는 추가 비용 부담도 없습니다.
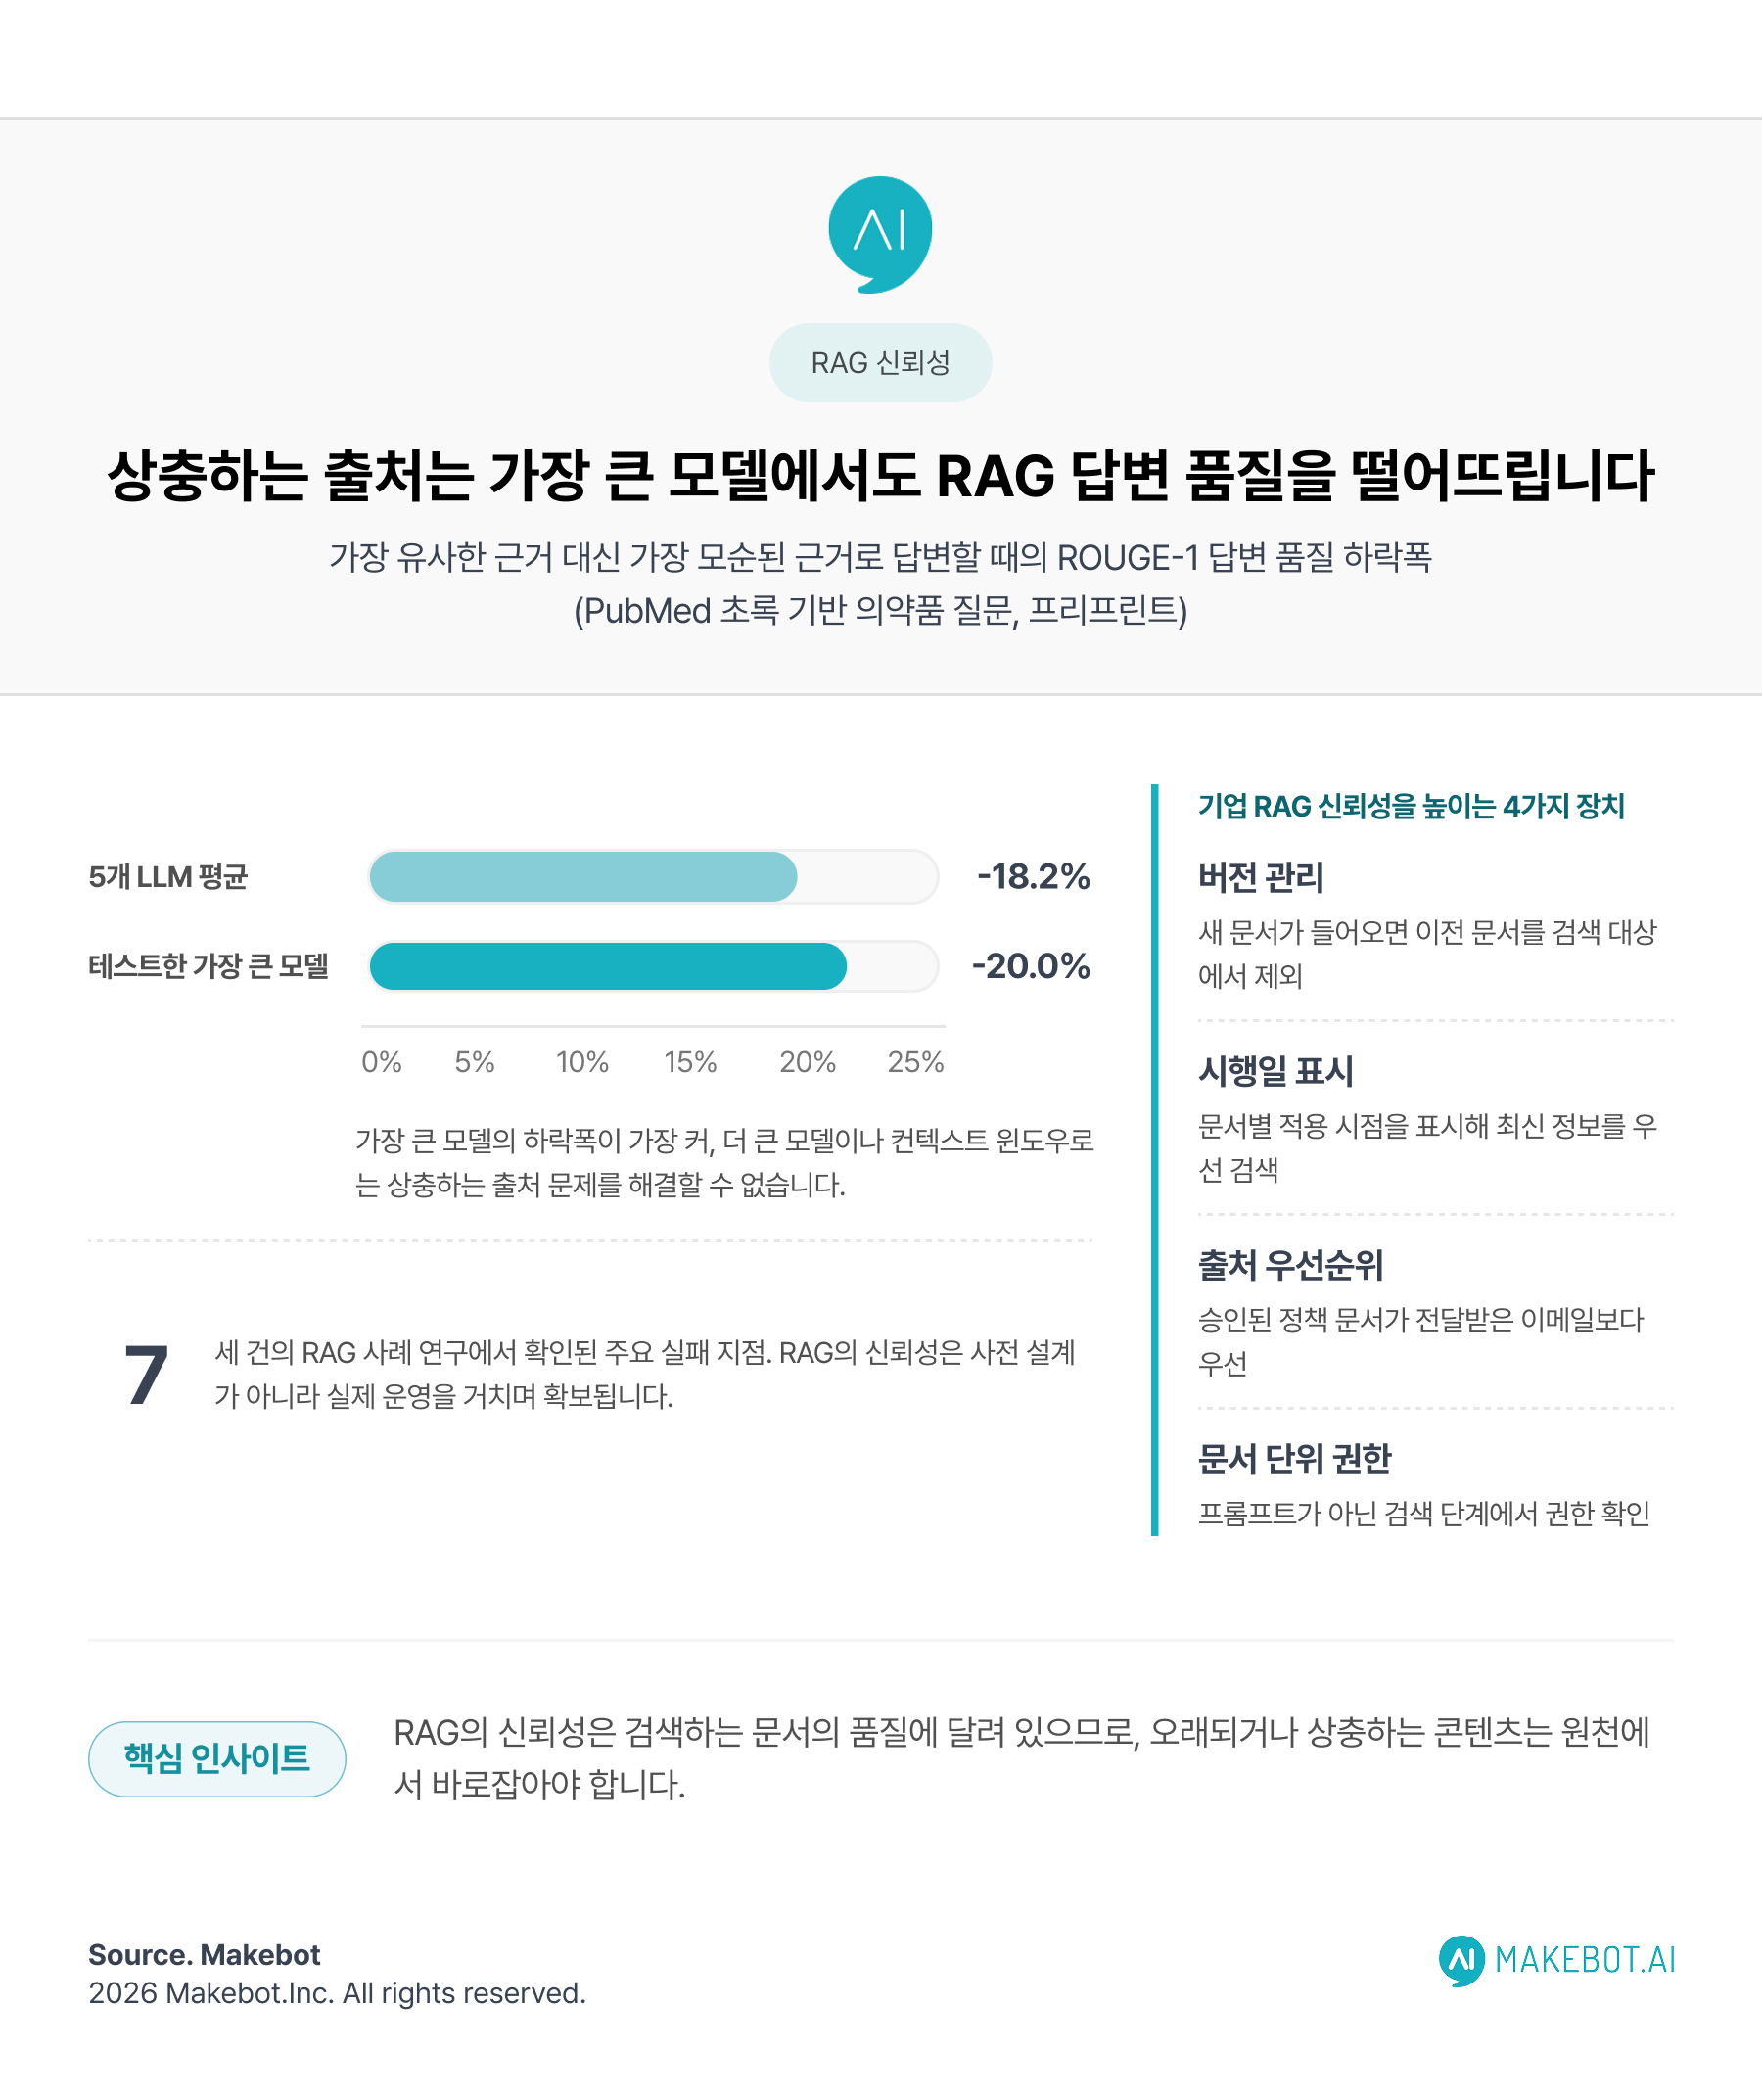
원천 데이터가 오래되었거나 서로 모순될 때 RAG는 어디서 무너집니까?
원천 데이터가 오래되었거나 모순되면 RAG는 검색 단계에서 잘못된 문서를 가져와 확신에 찬 오답을 만들며 무너집니다.
RAG는 흔히 AI 환각(hallucination) 문제의 해결책으로 소개되지만, 문서 자체를 신뢰할 수 있을 때만 제대로 작동합니다.
Deakin University 연구진이 CAIN 2024에서 발표한 연구는 세 개의 RAG 시스템에서 일곱 가지 실패 지점을 찾아냈고, 이런 시스템이 사전 설계가 아니라 실제 운영을 거치며 안정된다는 점을 확인했습니다. 아직 동료 심사를 거치지 않은 RMIT·Deakin 연구진의 프리프린트는 가장 유사한 근거와 가장 모순된 근거를 바탕으로 한 답변을 비교했습니다. 모순된 근거에서 ROUGE-1 점수는 평균 18.2%, 가장 큰 모델에서는 20% 하락했습니다. 컨텍스트 윈도우가 커져도 해결되지 않습니다. 읽는 양이 늘면 오래되고 상충하는 자료도 함께 늘기 때문입니다.
기업에서도 예전 환불 정책이나 서로 다른 매뉴얼이 같은 문제를 일으킵니다. 기업의 비정형 데이터를 다루는 RAG의 신뢰성을 높이려는 팀은 버전 관리, 시행일 표시, 출처 우선순위, 검색 단계의 문서 권한 확인을 추가합니다.
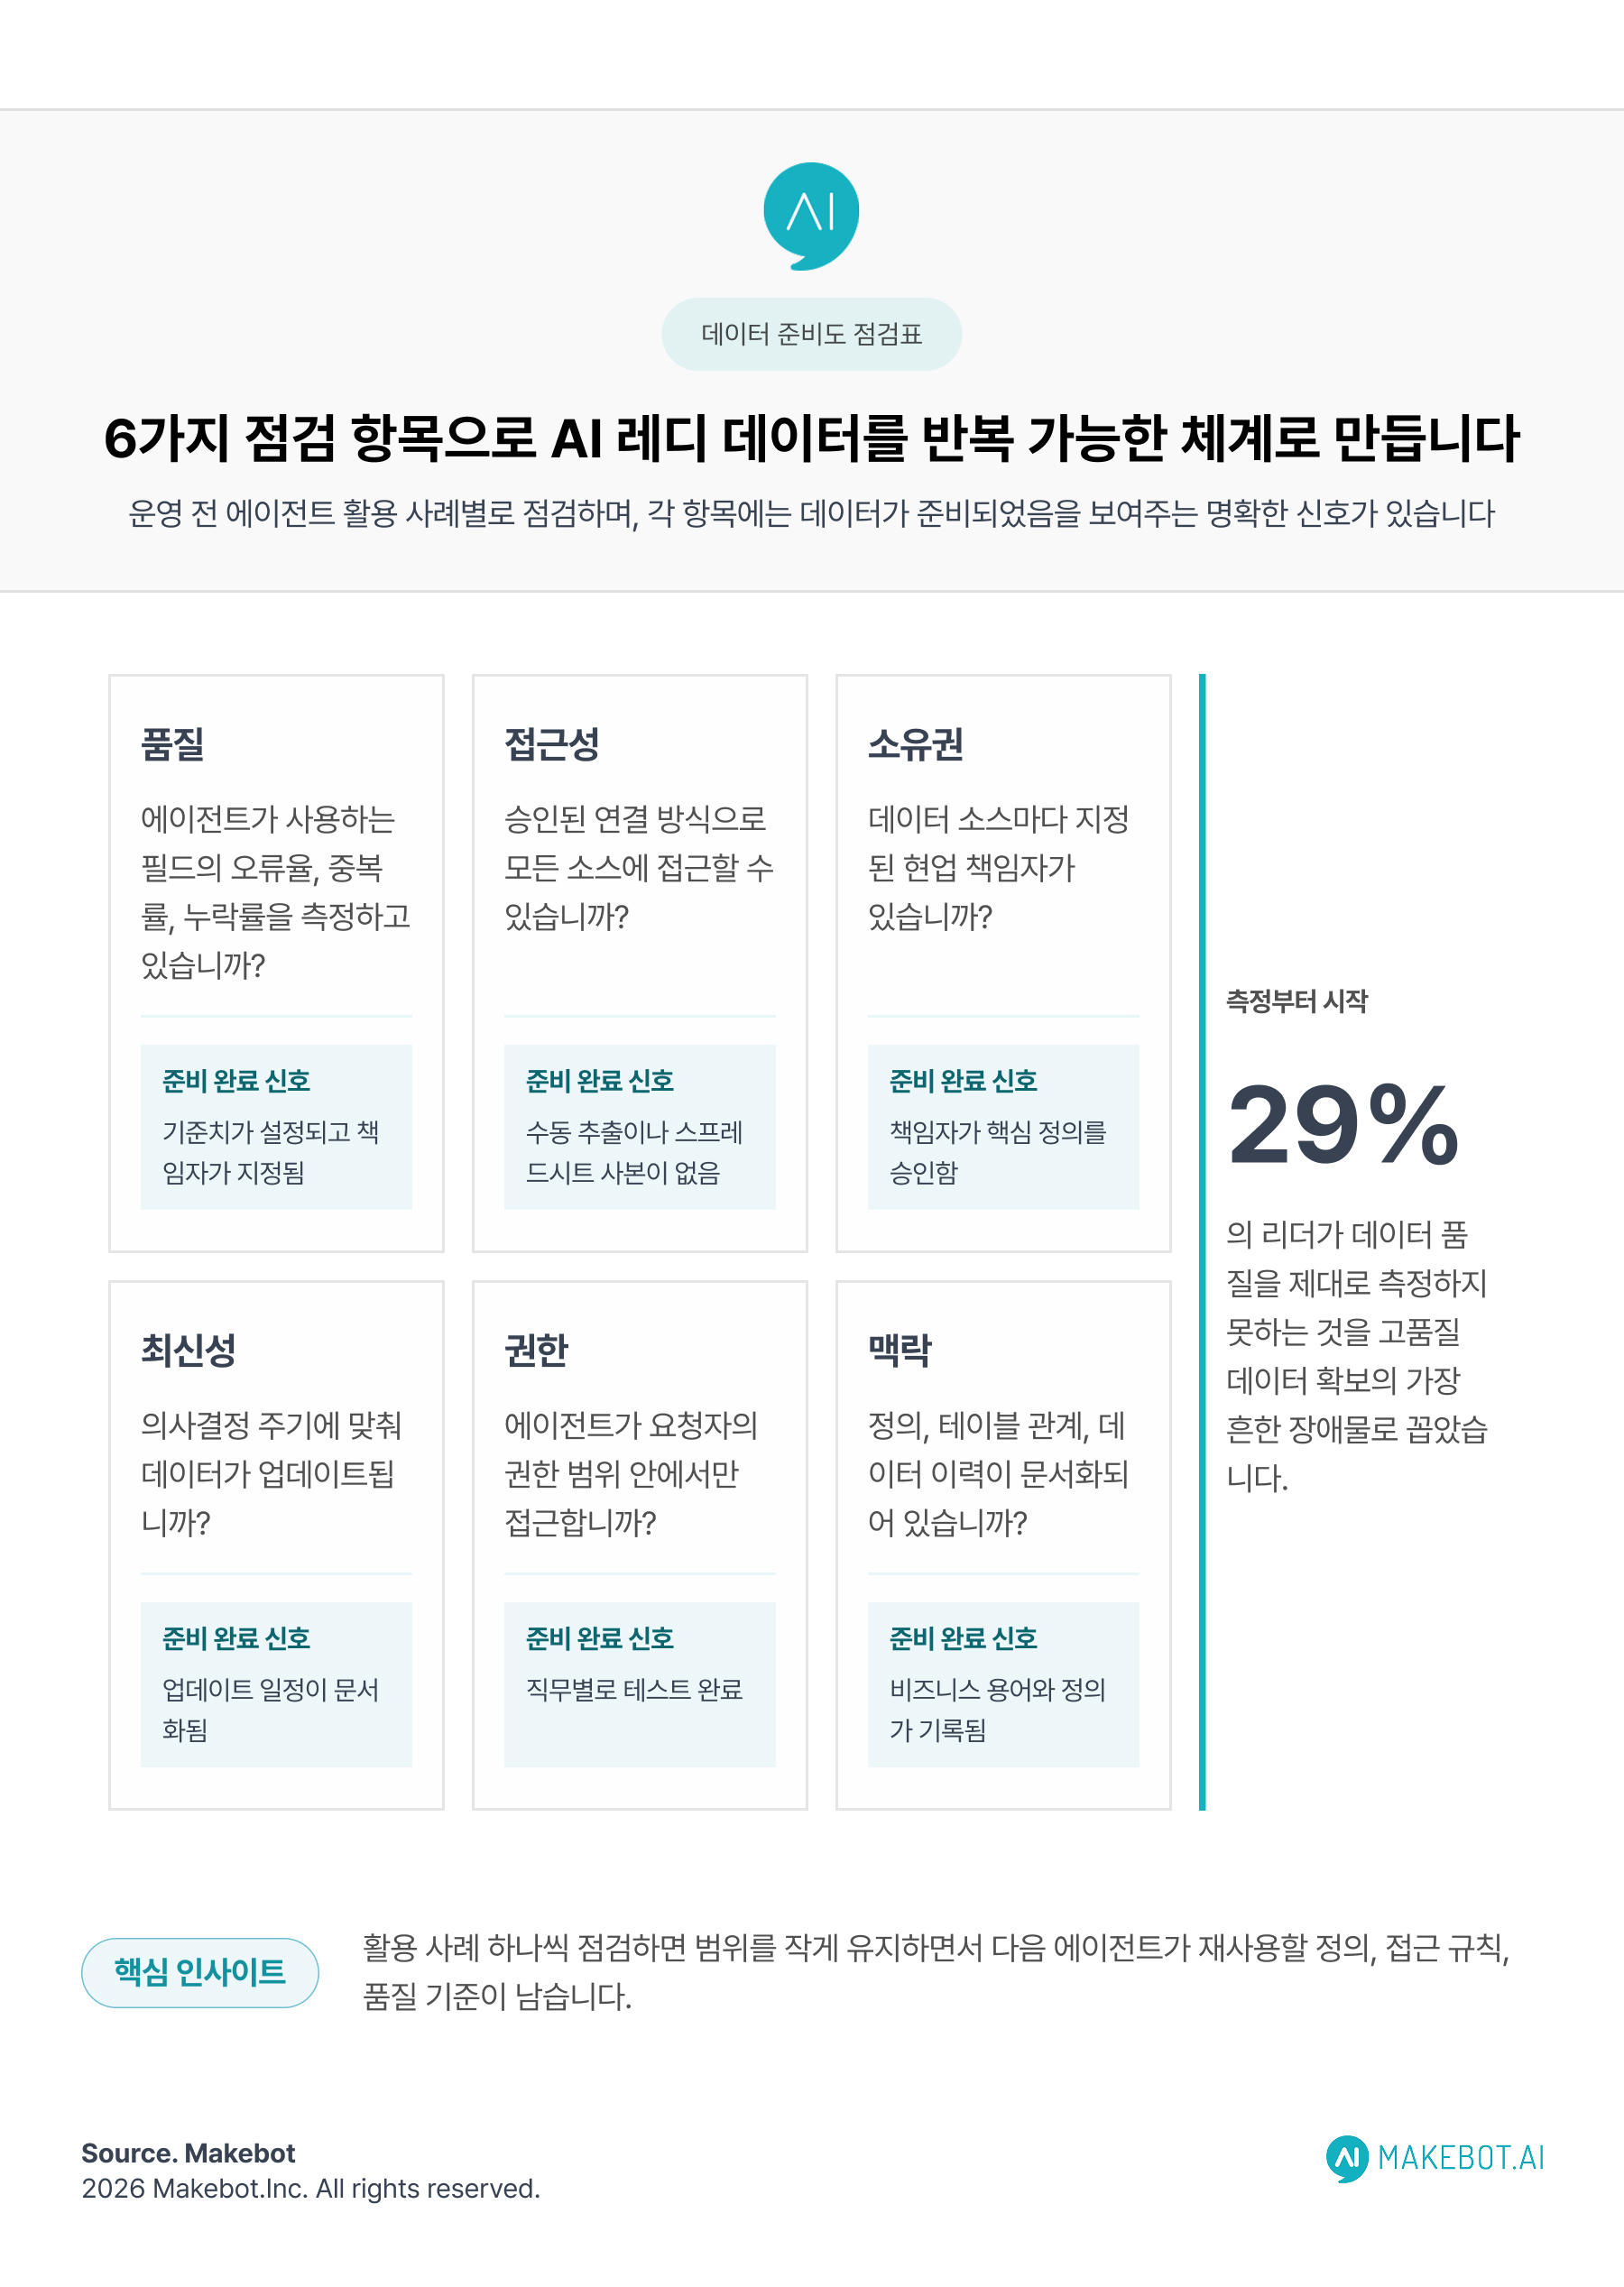
AI를 위한 데이터 준비도는 어떻게 진단합니까?
AI를 위한 데이터 준비도는 활용 사례 하나씩 품질부터 맥락까지 여섯 가지 항목으로 진단합니다.
여섯 가지 항목은 품질, 접근성, 소유권, 최신성, 권한, 비즈니스 맥락입니다. 명확하게 정의된 활용 사례 하나씩 접근하면 전사 프로젝트보다 범위를 작게 유지하고 성과를 더 빨리 확인할 수 있습니다. 측정이 먼저입니다. 리더의 29%가 데이터 품질을 제대로 측정하지 못하는 것을 가장 큰 장애물로 꼽았습니다.
AI 에이전트에서 데이터 거버넌스는 어떤 역할을 합니까?
AI 에이전트의 데이터 거버넌스는 데이터 소유자, 에이전트의 접근 범위, 작업 기록 방식을 정하는 역할을 합니다.
데이터 거버넌스는 신뢰도 높입니다. 거버넌스 프로그램을 갖춘 조직의 71%가 자사 데이터를 높이 신뢰한다고 답한 반면, 프로그램이 없는 조직은 50%에 그쳤습니다. 그럼에도 48%는 AI에 쓰이는 데이터를 관리하는 프로그램을 아직 마련하지 않았습니다.
가장 취약한 부분은 추적성입니다. 응답자의 65.1%가 AI 기반 의사결정은 설명 가능하고 추적 가능해야 한다고 답했지만, AI 입력·출력 기록과 원천 데이터로의 연결 고리를 모두 관리하는 곳은 10%에 불과했습니다.
OWASP GenAI Security Project는 AI가 맡은 일보다 큰 권한을 가진 상태를 'Excessive Agency(과도한 행위 권한)'라고 부릅니다. 2026년 Top 10 for LLM Applications는 이 위험을 3위로 꼽았으며, OWASP 가이드는 다섯 가지 통제 방안으로 이어집니다.
- 최소 권한: 활용 사례에 필요한 데이터에만 접근
- 사용자 권한으로 실행: 공용 관리자 계정 사용 금지
- 사람의 승인: 지급, 삭제 등 영향이 큰 작업은 사전 승인
- 대상 시스템에서 통제: AI의 판단에 맡기지 않음
- 로그 기록: 모든 작업을 기록
규제도 무게를 더합니다. EU AI Act Article 10은 채용, 신용도 평가처럼 Annex III에 명시된 고위험 용도에 문서화된 데이터 거버넌스를 요구하며, 해당 규정은 2027년 12월 2일부터 적용됩니다.
기업은 어떻게 데이터를 AI 레디 상태로 만들 수 있습니까?
기업은 하나의 활용 사례를 원천에서 정비하고 메타데이터와 통제 장치를 추가한 뒤 단계적으로 확장해 데이터를 AI 레디 상태로 만듭니다.
- 범위가 명확한 활용 사례 선정: 측정 가능한 목표가 있는 업무를 고릅니다.
- 데이터 흐름 파악: 소스, 책임자, 업데이트 일정, 권한을 정리합니다.
- 원천에서 문제 해결: 프롬프트가 아니라 원천 데이터를 고칩니다.
- 메타데이터와 통제 장치 추가: 정의, 테이블 관계, 민감도 라벨, 버전 정보를 추가합니다.
- 실제와 가까운 데이터로 테스트: 영향이 큰 작업에는 사람의 승인을 유지합니다.
- 재사용과 확장: 같은 점검 기준을 다음 활용 사례에 적용합니다.
모델 정확도만이 아니라 비즈니스 성과를 측정해야 합니다. AI 성과 지표를 비즈니스 목표와 연계한 조직은 31%에 불과하며, 이 때문에 데이터 투자의 필요성을 입증하기가 어렵습니다. 재작업 없이 완료된 작업 비율, 사람의 개입 빈도, 작업 1,000건당 데이터 관련 사고 건수, 다음 활용 사례 도입 기간을 추적하십시오.
기업 리더는 AI 레디 데이터를 위해 무엇부터 해야 합니까?
기업 리더는 AI 레디 데이터를 위해 데이터 준비를 에이전트 프로그램의 최우선에 두고, 모델 선택은 나중에 결정해야 합니다.
설문조사는 도입 속도가 신뢰를 앞지르고 있음을, 벤치마크는 강력한 모델도 문서화가 부족한 데이터베이스에서 실패함을, RAG 연구는 상충하는 출처가 모든 규모의 모델에서 답변 품질을 떨어뜨림을 보여줍니다.
AI 에이전트를 실제 운영 단계로 끌어올리는 조직의 공통점은 특정 벤더가 아니라 일하는 방식입니다. 이들은 비즈니스 맥락을 정의하고, 에이전트가 할 수 있는 일을 통제하며, 업무 단위로 데이터 준비를 갖춰 나갑니다. 실제 운영에 가장 가까운 활용 사례를 고르고, 여섯 가지 항목으로 점검한 뒤, 원천에서 문제를 해결하십시오. 새로운 LLM은 계속 출시될 것이며, 그 가치는 AI 데이터의 준비에 달려 있습니다.
파일럿을 넘어 실제 운영으로
인상적인 AI 파일럿과 실제로 작동하는 운영 에이전트 사이의 간극을 좁히려면, 깔끔한 데이터 인프라와 그 위에서 운영될 수 있도록 설계된 AI 플랫폼이 함께 필요합니다. 메이크봇(Makebot)은 이상적인 조건이 아닌 실제 조직 데이터 환경에서 작동하도록 설계된 기업용 AI 솔루션을 제공합니다. 처음부터 다시 구축하지 않고도 데모에서 실제 배포 가능한 결과로 나아갈 수 있습니다.
메이크봇(Makebot)의 AI 전략 백서 Vol.04 「PoC의 무덤에서 프로덕션으로: UIC로 완성하는 기업 AI 실행력 혁신」은 이 논의를 한 단계 더 발전시킵니다. 백서는 파편화된 데이터베이스와 고립된 지능형 섬(Intelligence Islands)이 실시간 통합 비즈니스 맥락 확보를 구조적으로 불가능하게 만드는 이유를 분석합니다. 해법으로는 상태·메모리·라우팅을 중앙에서 관리하고 모든 에이전트를 단일 진실 공급원(SSOT) 위에서 작동하게 하는 모델 독립적 계층, 통합 인텔리전스 코어(UIC)를 제시하며, Human-in-the-Loop(HITL) 게이트를 플랫폼 차원의 표준으로 내재화합니다. AI 에이전트를 파일럿에서 실제 운영으로 전환하려는 리더라면 백서를 무료로 다운로드해 전체 청사진을 확인해 보십시오.
About This Article
본 아티클은 메이크봇의 글로벌 리서치 조직이 영어로 초안을 작성한 후, 국내 엔터프라이즈 환경과 시장 맥락에 맞춰 한국어로 재구성·편집되었습니다. 메이크봇은 단순한 번역이나 요약이 아닌, 글로벌 AI 시장에서 논의되는 구조적 변화와 기술 흐름을 한국 기업이 실제로 적용 가능한 전략 언어로 전환하는 것을 콘텐츠의 핵심 원칙으로 삼고 있습니다. 본 아티클에 담긴 관점과 해석은 메이크봇이 수행해 온 다수의 엔터프라이즈 AI 프로젝트에서 축적된 실무 경험, 글로벌 리서치 조직의 지속적인 시장·기술 분석, 그리고 메이크봇 CEO의 기술적·전략적 검토를 거쳐 완성되었습니다.
This article is also available in English.